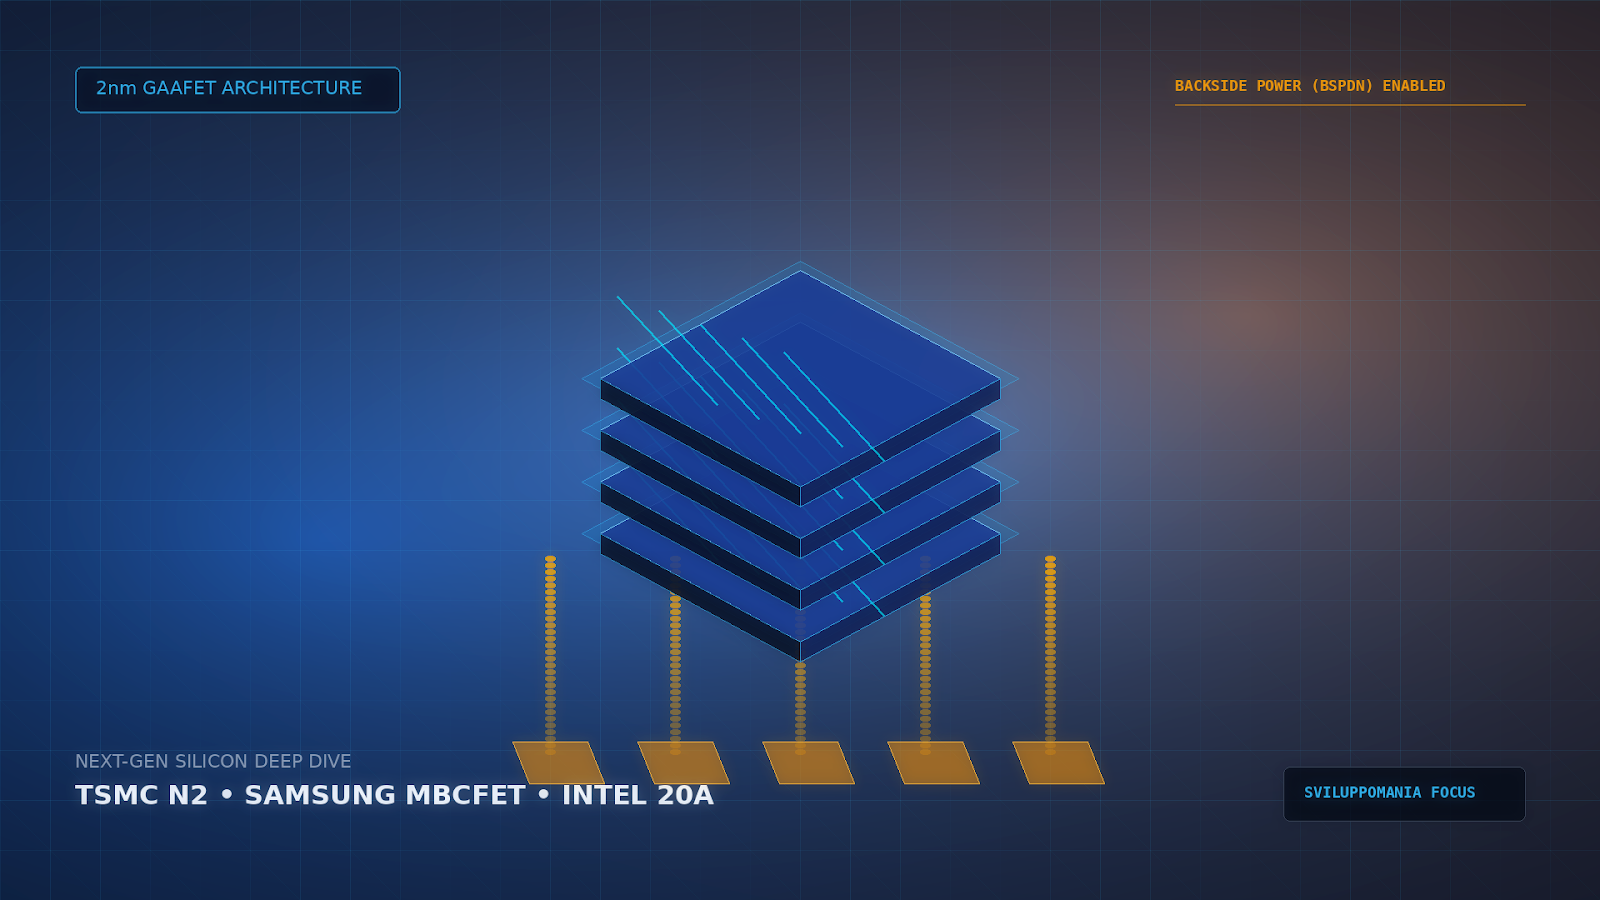
Per oltre cinquanta anni, la Legge di Moore ha scandito i ritmi dell’innovazione tecnologica imponendo il raddoppio costante della densità di commutazione logica a parità di superficie. Negli ultimi cicli produttivi, tuttavia, la tradizionale scalabilità geometrica si è scontrata contro i limiti invalicabili della termodinamica e della meccanica quantistica. Il debutto dei nodi di fabbricazione a 2 nanometri (nm) segna il punto di rottura più radicale dell’ultimo decennio: l’addio definitivo alla tecnologia FinFET e l’adozione delle architetture a fogli nanometrici sovrapposti (GAAFET), coadiuvate dall’introduzione della distribuzione di alimentazione dal retro del wafer (Backside Power Delivery). Questa transizione non rappresenta un semplice aggiornamento incrementale del silicio, ma una riprogettazione strutturale del modo in cui gli elettroni transitano attraverso i canali di conduzione dei semiconduttori moderni.
I limiti fisici del silicio e il collasso dell’architettura FinFET
Introdotta commercialmente all’inizio degli anni 2010 per superare le dispersioni parassite dei transistor planari 2D, l’architettura FinFET (Fin Field-Effect Transistor) ha consentito all’industria di scendere progressivamente dai 22nm fino ai raffinatissimi nodi a 3nm. La struttura a pinna tridimensionale permetteva al gate elettrostatico di avvolgere il canale conduttivo su tre lati distinti (superiore, sinistro e destro), garantendo una pressione di campo elettrico sufficiente ad arrestare il flusso elettronico nello stato di interruzione (off-state).
Tuttavia, quando il gate length (lunghezza fisica del gate) scende al di sotto dei 12 nanometri e lo spessore della pinna viene compresso oltre ogni margine di tolleranza atomica, la fisica dei semiconduttori presenta il conto. Tra i fenomeni degenerativi che hanno reso impraticabile proseguire con il FinFET sui nodi a 2nm figurano:
- Quantum Tunneling Sub-superficiale: a tensioni operative ridotte, gli elettroni riescono a oltrepassare la barriera energetica del canale sfruttando l’effetto tunnel quantistico, generando una corrente di fuga (leakage current) incontrollabile che drena energia a riposo e innalza la temperatura del package.
- Degradazione del DIBL (Drain-Induced Barrier Lowering): la vicinanza estrema tra source e drain riduce l’altezza della barriera elettrostatica controllata dal gate, rendendo il transistor parzialmente conduttivo anche in assenza di tensione di pilotaggio.
- Variazione statistica del drogaggio (RDF): la discrepanza del numero di atomi droganti in volumi nanometrici causa fluttuazioni critiche nella tensione di soglia (Vth) da transistor a transistor sullo stesso die.
Fisica dei GAAFET: Come funzionano i nanosheet sovrapposti
La risposta dell’ingegneria dei materiali a questo stallo prende il nome di GAAFET (Gate-All-Around Field-Effect Transistor). Sebbene implementata con denominazioni commerciali differenti dai vari attori del mercato (TSMC ne conserva il nome generico GAA, Samsung la identifica come MBCFET – Multi-Bridge Channel FET, mentre Intel la adotta con il marchio RibbonFET), la teoria fisica sottostante è condivisa.
Nel GAAFET, la pinna verticale del FinFET viene sezionata e ruotata orizzontalmente in una pila di sottilissimi nastri o fogli di silicio (nanosheets) sospesi l’uno sull’altro. Il materiale dielettrico ad alto k (high-k metal gate) viene depositato chimicamente in modo tale da insinuarsi nello spazio intermedio tra ciascun foglio, avvolgendo letteralmente il canale su tutti e quattro i lati perimetrali a 360 gradi.
Questo confinamento spaziale totale ripristina il dominio elettrostatico ideale: il gate esercita un controllo uniforme sull’intera sezione trasversale del canale, eliminando le vie di fuga parassite nel substrato. Inoltre, mentre l’altezza della pinna FinFET era vincolata rigidamente dai processi di incisione litografica, la larghezza orizzontale dei nanosheet può essere variata parametricamente durante la progettazione (da 15nm a oltre 50nm). Un nanosheet più largo offre correnti di drive più elevate per i blocchi ad alta frequenza (core di calcolo primari), mentre nanosheet più stretti minimizzano il consumo nei blocchi logici a bassa attività.
Backside Power Delivery Network (BSPDN): Il disaccoppiamento di potenza e segnale
Parallelamente alla revisione geometrica del canale conduttore, i nodi litografici a 2nm integrano quella che molti fisici considerano la vera svolta ingegneristica dell’architettura computazionale moderna: il Backside Power Delivery Network (BSPDN), noto commercialmente come Intel PowerVia o TSMC Super Power Rail (SPR).
Nella tradizionale fabbricazione frontside dei chip, sia i percorsi dei segnali logici sia le linee metalliche di alimentazione elettrica (Vdd e Ground) vengono stratificati uno sopra l’altro sul lato superiore del wafer di silicio. Man mano che i transistor sono stati miniaturizzati, le piste metalliche superiori si sono assottigliate fino a creare una congestione drammatica: i fili di rame microscopici presentano un’elevata resistenza intrinseca, che provoca una caduta di potenziale sensibile nota come IR Drop. Parte considerevole dell’energia immessa viene dispersa in calore parassita ancor prima di raggiungere la giunzione logica.
Il BSPDN rovescia completamente questo paradigma: la rete di erogazione dell’energia viene trasferita interamente sul retro del wafer di silicio. Il silicio viene assottigliato meccanicamente e chimicamente fino a uno spessore di pochi micrometri, dopodiché le linee di potenza vengono collegate direttamente alle celle standard tramite fori passanti verticali (Nano-Through Silicon Vias o Nano-TSV). I benefici sistemici sono quantificabili:
- Eliminazione delle cadute di tensione: riduzione dell’IR Drop stimata tra il 15% e il 30%, consentendo ai core di operare stabilmente a tensioni nominali inferiori.
- Decongestione delle interconnessioni logiche: la superficie frontale rimane a uso esclusivo dei bus di comunicazione dati, riducendo le capacità parassite inter-metallo e permettendo frequenze di clock più elevate a parità di calore dissipato.
- Compattazione dell’area logica: le celle standard guadagnano fino al 10-15% di spazio utile, massimizzando la densità di transistor per millimetro quadrato senza richiedere un restringimento estremo delle maschere EUV.
Matrice Comparativa: Metriche Fisiche e Parametri di Efficienza
Il passaggio generazionale tra i nodi commerciali a 3nm di seconda generazione e le nuove architetture a 2nm basate su GAAFET e alimentazione posteriore evidenzia progressi tangibili nei parametri operativi:
| Parametro Architetturale | Nodo 3nm (FinFET Ottimizzato) | Nodo 2nm (GAAFET + BSPDN) | Impatto Ingegneristico |
|---|---|---|---|
| Confinamento del Gate | Tri-gate (Superficie su 3 lati) | All-Around (Fogli avvolti a 360°) | Azzeramento quasi totale dei leakage |
| Densità dei Transistor (MTr/mm²) | ~220 – 280 MTr/mm² | ~340 – 400 MTr/mm² | Incremento medio del +20% di logica utile |
| Tensione Operativa Minima (Vmin) | ~0.65V – 0.70V | ~0.52V – 0.58V | Funzionamento stabile a bassissimo voltaggio |
| Routing Alimentazione | Frontside Tradizionale (M0/M1 condivisi) | Backside Diretto (Retro del wafer) | Isolamento termico e abbattimento IR Drop |
| Resa Efficienza a Pari Frequenza | Baseline di riferimento | -25% / -30% assorbimento energetico | Margine termico esteso per carichi continui |
Implicazioni Pratiche: Dalle NPU Edge ai Data Center Hyperscale
Cosa comporta questa evoluzione nei carichi di lavoro concreti? Sul fronte dei dispositivi mobili e portatili, la compressione delle dispersioni energetiche a riposo risolve uno dei colli di bottiglia più critici: il thermal throttling indotto dai cluster di intelligenza artificiale on-device.
I modelli linguistici di grandi dimensioni (LLM quantizzati a 4 o 8 bit) e le pipeline di visione artificiale richiedono un accesso continuo e massiccio ai vettori di calcolo delle NPU (Neural Processing Units). In un’architettura FinFET a 3nm, la concentrazione di calore localizzata in aree ristrette del die costringe i governor del kernel a tagliare rapidamente le frequenze operative per preservare l’integrità del package e la temperatura superficiale dello smartphone. Con il controllo elettrostatico dei 2nm GAAFET e l’efficienza della distribuzione BSPDN, le NPU integrate possono sostenere carichi computazionali costanti con potenze inferiori a 3-4 Watt, abilitando l’elaborazione di agenti AI multimodali in tempo reale senza degradazione prestazionale prolungata.
Parallelamente, negli ambienti server per l’addestramento e l’inferenza nei data center, l’abbattimento dell’IR Drop del 20% si riflette direttamente su scala macroscopica: la riduzione del PUE (Power Usage Effectiveness) globale e la possibilità di incrementare il clock dei cluster multichiplet a parità di sistemi di raffreddamento a liquido rappresentano un risparmio operativo calcolabile in milioni di kilowattora per singola server farm.
Domande Frequenti (FAQ)
Il passaggio ai 2nm comporterà solo batterie con maggiore autonomia?
L’efficienza energetica guadagnata non viene quasi mai spesa per il solo risparmio della batteria. I produttori di chip convertono il surplus termico per alimentare blocchi architetturali più esigenti, come Neural Processing Unit con un numero superiore di TOPS (Tera Operations Per Second), memorie cache unificate più estese e cluster grafici in grado di operare a frequenze stabili senza strozzature termiche.
Qual è la differenza fondamentale tra RibbonFET, MBCFET e GAAFET?
Si tratta di denominazioni commerciali e varianti proprietarie che poggiano sullo stesso principio fisico: la tecnologia Gate-All-Around. GAAFET è il termine tecnico standard della comunità ingegneristica; MBCFET (Multi-Bridge Channel FET) è il nome registrato da Samsung per i suoi fogli nanometrici; RibbonFET è il marchio adottato da Intel per la propria implementazione proprietaria a nanosheet.
Perché l’alimentazione posteriore (BSPDN) è considerata complessa da produrre?
Implementare il BSPDN richiede la lavorazione di entrambe le facce del wafer di silicio. Dopo aver creato i transistor sul lato frontale, il wafer deve essere incollato a un supporto ausiliario, ribaltato, assottigliato con una levigatura nanometrica e forato con precisione atomica per allineare i canali verticali (Nano-TSV) ai contatti logici preesistenti, con margini di errore inferiori a pochi nanometri.
Quando assisteremo alla piena diffusione sul mercato di massa?
La produzione su volumi commerciali di punta è entrata nelle pipeline industriali nel 2026. L’integrazione segue la consueta scaletta del settore: prima sui chiplet dei processori mobile premium e negli acceleratori per il calcolo scientifico, per poi diffondersi capillarmente nell’hardware consumer e nelle piattaforme desktop nei semestri successivi.
Ti è piaciuto questo approfondimento?
Resta sempre aggiornato su news, guide e tendenze tech: scarica l’app ufficiale di SviluppoMania sul tuo store preferito.
 |
|
|